Agent 基本范式:ReAct、Plan-and-Execute 与 Reflexion
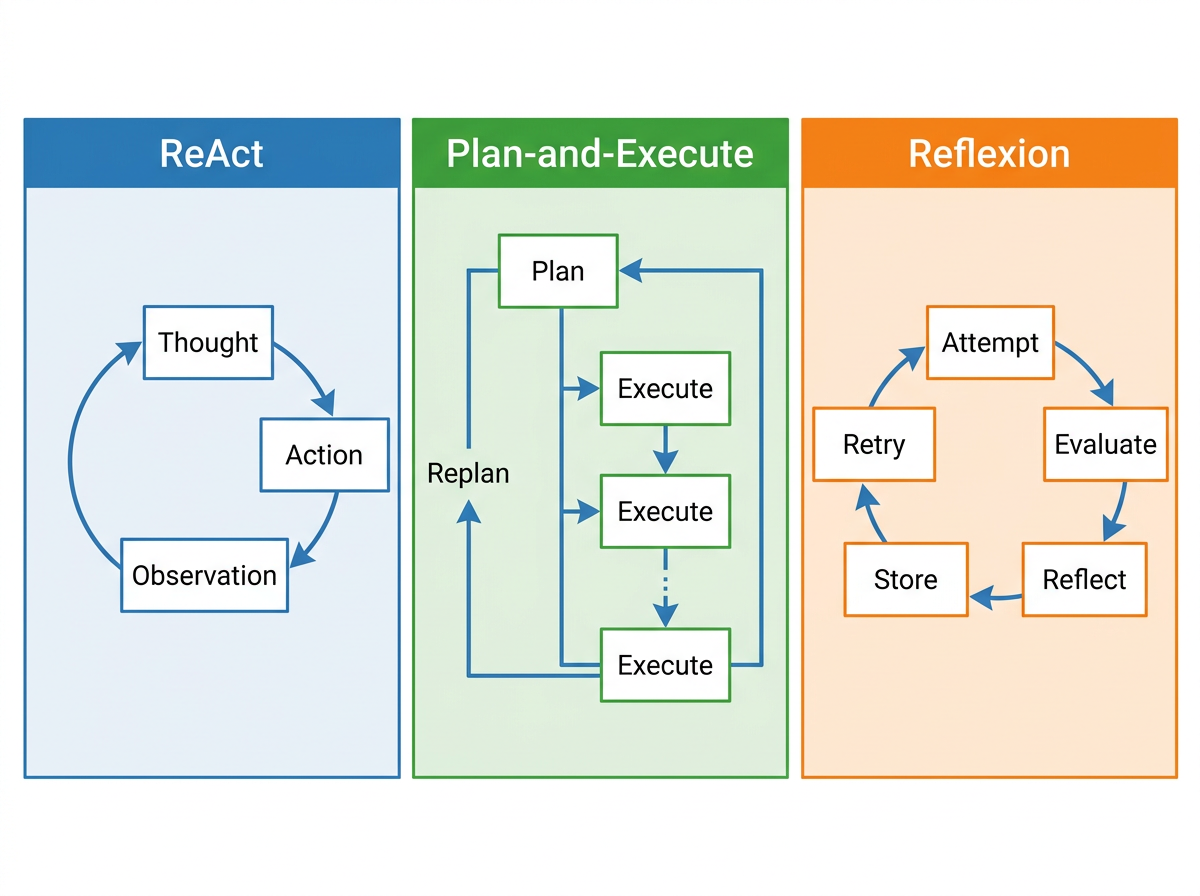
Agent 的核心设计问题在于:智能体应当如何组织其"思考"与"行动"的循环?不同的范式选择深刻地影响着 Agent 的行为特征、推理质量与适用场景。本节将深入剖析三大经典 Agent 范式,理解它们的内在机制与设计权衡。
ReAct:推理与行动交织
ReAct(Reasoning + Acting)范式由 Yao 等人于 2022 年提出,其核心思想是将推理(Thought)与行动(Action)在同一轮交互中交替进行。Agent 在每一步中先产出一段内部推理,解释当前观察与下一步行动之间的逻辑关联,然后执行一个具体行动获取环境反馈,再基于新观察继续推理。
这一范式的关键优势在于:
- 推理可追溯:每一步行动都有明确的思考过程支撑,而非凭直觉跳跃,使得 Agent 的决策链可审计、可调试。
- 行动有依据:推理步骤为行动提供了"为什么这么做"的 rationale,避免了盲目的工具调用或随机探索。
- 错误可纠正:当环境反馈表明行动未达预期时,Agent 能在后续推理中识别偏差并调整策略,形成自然的纠错循环。
ReAct 的典型流程表现为:Thought → Action → Observation → Thought → Action → Observation ...,直到任务完成或达到终止条件。这一模式在问答、信息检索、游戏交互等需要与环境持续交互的场景中表现优异。
然而 ReAct 也有其局限:由于推理与行动紧密交织,Agent 容易陷入局部最优——每一步的思考仅基于最近的观察,缺乏对全局任务结构的把握,导致在长链任务中出现方向偏离。
Plan-and-Execute:先规划后执行
Plan-and-Execute 范式针对 ReAct 的局部性缺陷提出了结构性改进。其核心机制分为两个阶段:
- 规划阶段(Plan):Agent 在任务开始时先生成一份完整的多步执行计划,明确各个子步骤的目标、依赖关系与执行顺序。
- 执行阶段(Execute):Agent 按照既定计划逐步执行每个子步骤,并在每步完成后评估结果是否与预期一致。
当执行中发现偏差时,Agent 可以重新规划(Replan)——根据当前状态与偏差信息调整后续计划,而非简单地继续按原计划推进。这种"规划-执行-重规划"的循环赋予了 Agent 全局视角与局部灵活性的双重能力。
Plan-and-Execute 的优势体现在:
- 全局一致性:初始规划确保了整个任务的方向正确,避免了逐步推理可能产生的累积偏差。
- 步骤可追踪:计划本身作为任务的结构化表达,使得进度监控与异常定位变得直观。
- 灵活重规划:遇到意外情况时不是被动修正,而是主动重新审视全局策略。
该范式尤其适用于结构明确、步骤间有强依赖的复杂任务,如多步骤数据处理流程、项目管理与自动化运维。代价是规划本身消耗额外的 LLM 调用,且初始规划质量直接决定执行效率——如果初始规划本身存在缺陷,后续的重规划可能反复消耗资源。
Reflexion:自我反思与迭代改进
Reflexion 范式由 Shinn 等人于 2023 年提出,在 ReAct 的基础上引入了**语言化的自我反思(Verbal Reflection)**机制。当 Agent 完成一次任务尝试(无论成功或失败)后,它会生成一段反思评述,分析哪些决策导致了错误、哪些策略值得保留、下一次尝试应当如何改进。这些反思被存储在长期记忆中,在后续任务尝试中被检索与参考。
Reflexion 的核心循环为:
Attempt → Evaluation → Reflection → Store → Re-attempt (with reflections)
这一范式的独特价值在于:
- 从失败中学习:不再是单次尝试的即时纠错,而是跨尝试的系统性经验积累,Agent 的表现随迭代次数显著提升。
- 反思可迁移:针对同类任务,历史反思能够被检索并指导新尝试,形成了类似人类"经验总结"的能力。
- 评估驱动:每次尝试后都有明确的评估环节,使得反思不是泛泛的自我评论,而是基于具体失败信号的精准诊断。
Reflexion 在需要多次尝试与试错的场景中效果显著,如代码调试、策略游戏、复杂搜索任务。然而其迭代成本较高——每次反思都意味着额外的 LLM 调用,且反思质量依赖于评估信号的准确性与丰富度。
三大范式对比与选择
| 维度 | ReAct | Plan-and-Execute | Reflexion |
|---|---|---|---|
| 推理模式 | 逐步交织 | 全局规划后执行 | 尝试后反思迭代 |
| 全局视野 | 较弱 | 强 | 中等(依赖反思积累) |
| 灵活性 | 高(即时调整) | 中(依赖重规划) | 高(跨尝试改进) |
| 适用场景 | 交互密集型任务 | 结构化复杂任务 | 试错与迭代型任务 |
| 计算成本 | 中 | 较高(规划+执行) | 高(多次尝试+反思) |
在实际系统设计中,三大范式并非互斥。许多现代 Agent 框架采用混合策略:在 Plan-and-Execute 的全局规划框架内,每个子步骤的执行采用 ReAct 的交织模式;当整体任务失败时,通过 Reflexion 的反思机制总结教训并优化后续任务的规划质量。选择何种范式或组合,取决于任务特性、成本预算与可靠性要求。
本章小结
| 范式 | 核心循环 | 全局视野 | 最佳场景 | 计算成本 |
|---|---|---|---|---|
| ReAct | Thought → Action → Observation | 较弱 | 交互密集型任务(问答、检索) | 中 |
| Plan-and-Execute | Plan → Execute → Replan | 强 | 结构化复杂任务(数据处理、运维) | 较高 |
| Reflexion | Attempt → Evaluate → Reflect → Retry | 中等 | 试错迭代型任务(代码调试、策略游戏) | 高 |
实践建议:
- 先用 ReAct 快速验证交互逻辑
- 任务超过 5 步时引入 Plan-and-Execute
- 需要反复试错的场景加入 Reflexion
- 生产环境推荐混合策略:全局规划 + 局部 ReAct + 失败反思
📖 延伸阅读
- ReAct: Synergizing Reasoning and Acting in Language Models —— ReAct 原论文
- Reflexion: Self-Reflective Agents —— Reflexion 原论文
- LangGraph Plan-and-Execute —— 官方实现示例
- OpenAI Agents SDK —— 官方 Agent 开发指南